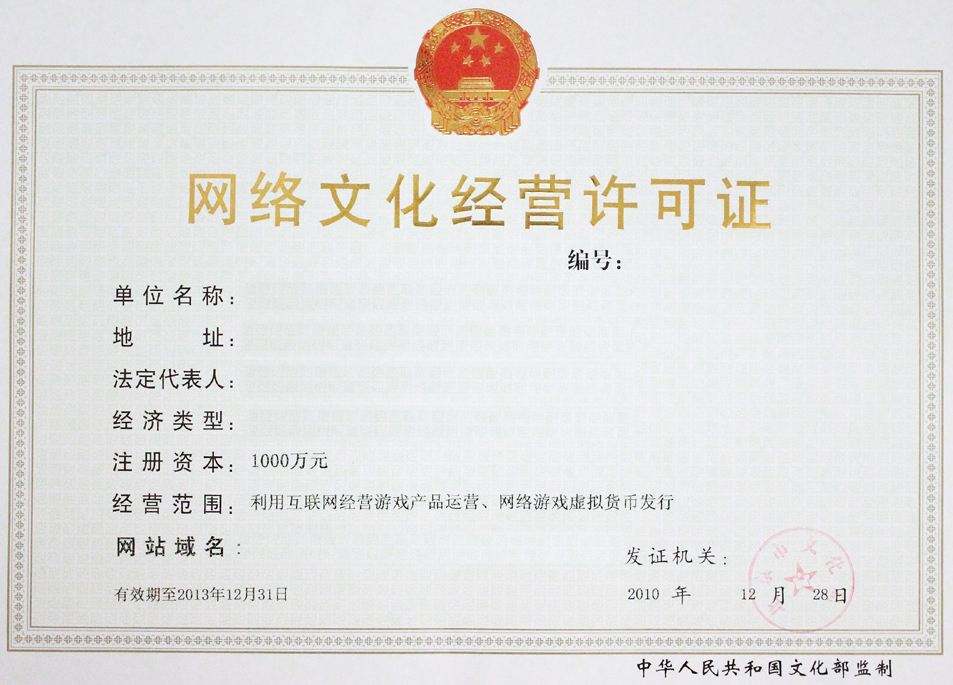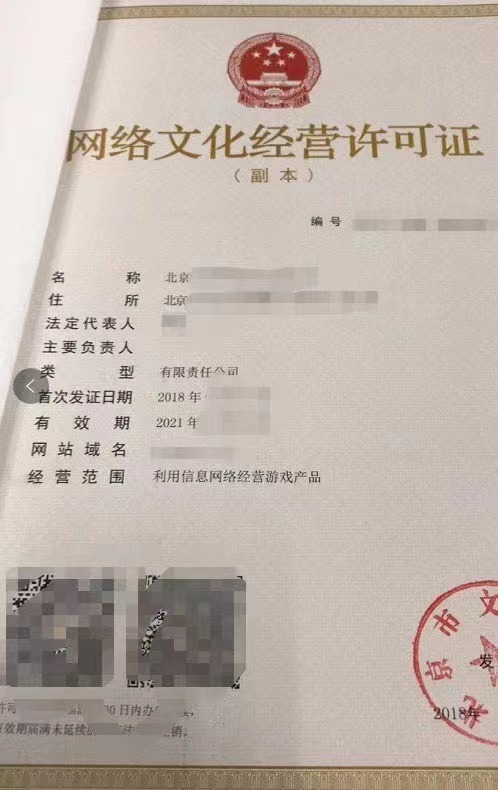
一、引言\n\n随着互联网文化产业的快速发展,网络文化经营许可证(以下简称“文网文”)成为从事网络音乐、网络演出剧目、网络表演、网络艺术品、动漫、游戏等文化产品经营活动的必备资质。对于监管部门、平台审核团队以及企业合规部门而言,高效、准确地提取和验证许可证信息是一项高频且繁琐的工作。OCR(光学字符识别)文字识别技术的引入,为网络文化经营许可证的自动化识别提供了可行的解决方案。\n\n## 二、什么是网络文化经营许可证OCR识别\n\n网络文化经营许可证OCR识别是指利用光学字符识别技术,对文网文证照图片进行自动分析,定位证件中的关键字段区域,并以结构化形式输出文字内容的过程。其核心目标是将非结构化的图像数据转换为可检索、可校验的结构化信息。\n\n## 三、证件关键字段与识别要点\n\n网络文化经营许可证通常包含以下关键字段:\n\n1. 许可证编号:由字母与数字组成,是唯一标识证书的关键编码,识别时需注意字符混淆(如 E 与 F、0 与 O、1 与 I)。\n2. 单位名称:企业或机构的完整法定名称,常含生僻字及较长字符串,需关注识别准确率。\n3. 法定代表人:负责人姓名,中文名字识别相对成熟,但仍需处理字体艺术化问题。\n4. 住所与经营地址:涉及省市区街道等长文本,需保证字段完整性。\n5. 经营范围:文网文的核心内容,通常列举多项业务类别,存在换行、多栏排版的情况。\n6. 有效期:包括起始日期与截止日期,格式多为“YYYY年MM月DD日”,需进行日期格式规范化。\n7. 发证机关与发证日期:印章与文字并存区域,识别难度相对较高。\n\n证件上还包含国徽图案、底纹纹理、自定义字体及防伪元素,这些都为识别带来一定挑战。\n\n## 四、技术实现流程\n\n一份完整的文网文OCR识别流程通常包括以下步骤:\n\n### 1. 图像预处理\n- 去噪与增强:对拍摄角度倾斜、光照不均、对比度低的图像进行灰度化、二值化、去噪处理。\n- 版面矫正:通过边缘检测与透视变换校正证件倾斜或扭曲,恢复标准版式。\n- 区域分割:利用模板匹配或语义分割定位证件主体区域,裁剪无效背景。\n\n### 2. 文本检测\n采用基于深度学习的文本检测模型(如 DBNet、PSENet)定位图像中的文字行或文字块,输出区域坐标,既能覆盖横排文本,也能处理部分竖排或倾斜文本。\n\n### 3. 文本识别\n在检测基础上,使用 CRNN、SVTR 等序列识别模型对文字区域进行字符识别。对于中文场景,需选用包含大量中文样本训练的网络模型,并根据证照字体特点做数据增强或微调训练。\n\n### 4. 结构化抽取\n通过规则引擎与字段模板,将识别出的文本序列按预设字段(编号、名称、经营范围等)进行映射和归一化。例如,利用正则匹配提取证书号与日期,利用文本行相对位置判断字段的对应关系。\n\n### 5. 后处理与校验\n- 基于业务规则校验编号格式及经营范围合理性;\n- 结合知识库(如企业名称库)对容易混淆字段做二次候选项校准;\n- 针对无法确定的字段输出低置信标记,联动人工复核。\n\n## 五、重点与难点\n\n### 重点\n- 高精度字符识别:确保经营范围和许可证编号等核心字段的字符错误率尽可能低。\n- 字段自动对应:多种版式规则或自由排版的许可证需要通过投影法或语义对齐将检测到的内容填入正确的关键字段。\n\n### 难点\n- 证照拍照条件多变性:用户手持、倾斜角度、证件压褶、反光或荫蔽等都会影响效果,鲁棒性是落地关键。\n- 模糊与低质文档的恢复:有的网络文化经营许可证图片像素较小或摄像传输降质明显,需要对裁剪放大和对抗性网络等深度学习前后处理全面结合。\n- 密集较长的经营范围书写带来的换行错位识别输入模型已较成熟,文本抽取粒度保证一个证书上产生多种细分类型内容正确跳变顺序,不标签合并较需要注意模版问题。\n- 多方证据辅助**:不仅仅文字字意含糊而要语义匹配防伪校验也是系统安全设计需要考虑的开发重点不过可以把外围验证风控制辅助内部正常信息模型核查对齐。\n## 六应用场景介绍六大场景\n\